Un paro no programado rara vez comienza cuando se detiene la línea. Normalmente inicia antes: una alarma ignorada, una señal inestable, un variador con fallas intermitentes, una refacción obsoleta o una modificación de software sin respaldo ni pruebas. Entender cómo reducir paros industriales exige identificar esas condiciones antes de que afecten la producción, la calidad, la seguridad o el cumplimiento de entregas.
En una planta de proceso o manufactura, la disponibilidad no depende únicamente del mantenimiento mecánico. PLC, HMI, SCADA, instrumentación de campo, redes industriales, tableros eléctricos, motores y lógica de control forman una cadena operativa. Una falla en cualquiera de estos puntos puede detener un equipo aislado o propagar el paro hacia una línea completa.
Cómo reducir paros industriales desde la ingeniería
Reducir paros no consiste en agregar alarmas o sustituir equipos de forma indiscriminada. Requiere una estrategia basada en criticidad, evidencia de fallas, condiciones reales de operación y capacidad de mantenimiento. El primer paso es diferenciar los paros repetitivos de los eventos excepcionales.
Los paros repetitivos suelen revelar problemas de diseño, parametrización, obsolescencia o falta de control del cambio. Por ejemplo, un transportador que se detiene por sobrecarga puede tener un problema mecánico, pero también una mala selección del variador, rampas de aceleración inadecuadas, protecciones mal ajustadas o una secuencia PLC que no coordina correctamente los equipos aguas arriba y aguas abajo.
Los eventos excepcionales, en cambio, pueden requerir redundancia, inventario de refacciones críticas, rutas de recuperación y procedimientos de respuesta. No toda falla justifica duplicar hardware. La decisión depende del impacto en seguridad, producción, calidad, tiempo de recuperación y disponibilidad de sustitutos compatibles.
Clasifique la criticidad con datos de operación
Una lista de fallas no es todavía un diagnóstico. Conviene registrar el equipo afectado, hora, duración, modo de falla, alarma activa, condición de proceso, intervención realizada y tiempo real para recuperar la operación. Si la información queda solo en bitácoras libres o mensajes de operador, será difícil identificar patrones y priorizar inversiones.
Con esta base, mantenimiento, operaciones e ingeniería pueden establecer una matriz de criticidad. Los activos que detienen toda la producción, generan riesgo operacional, comprometen un lote o requieren componentes con largo tiempo de entrega deben tratarse primero. También es necesario distinguir entre el tiempo de corrección técnica y el tiempo perdido por diagnóstico, autorizaciones, acceso, falta de planos o espera de refacciones.
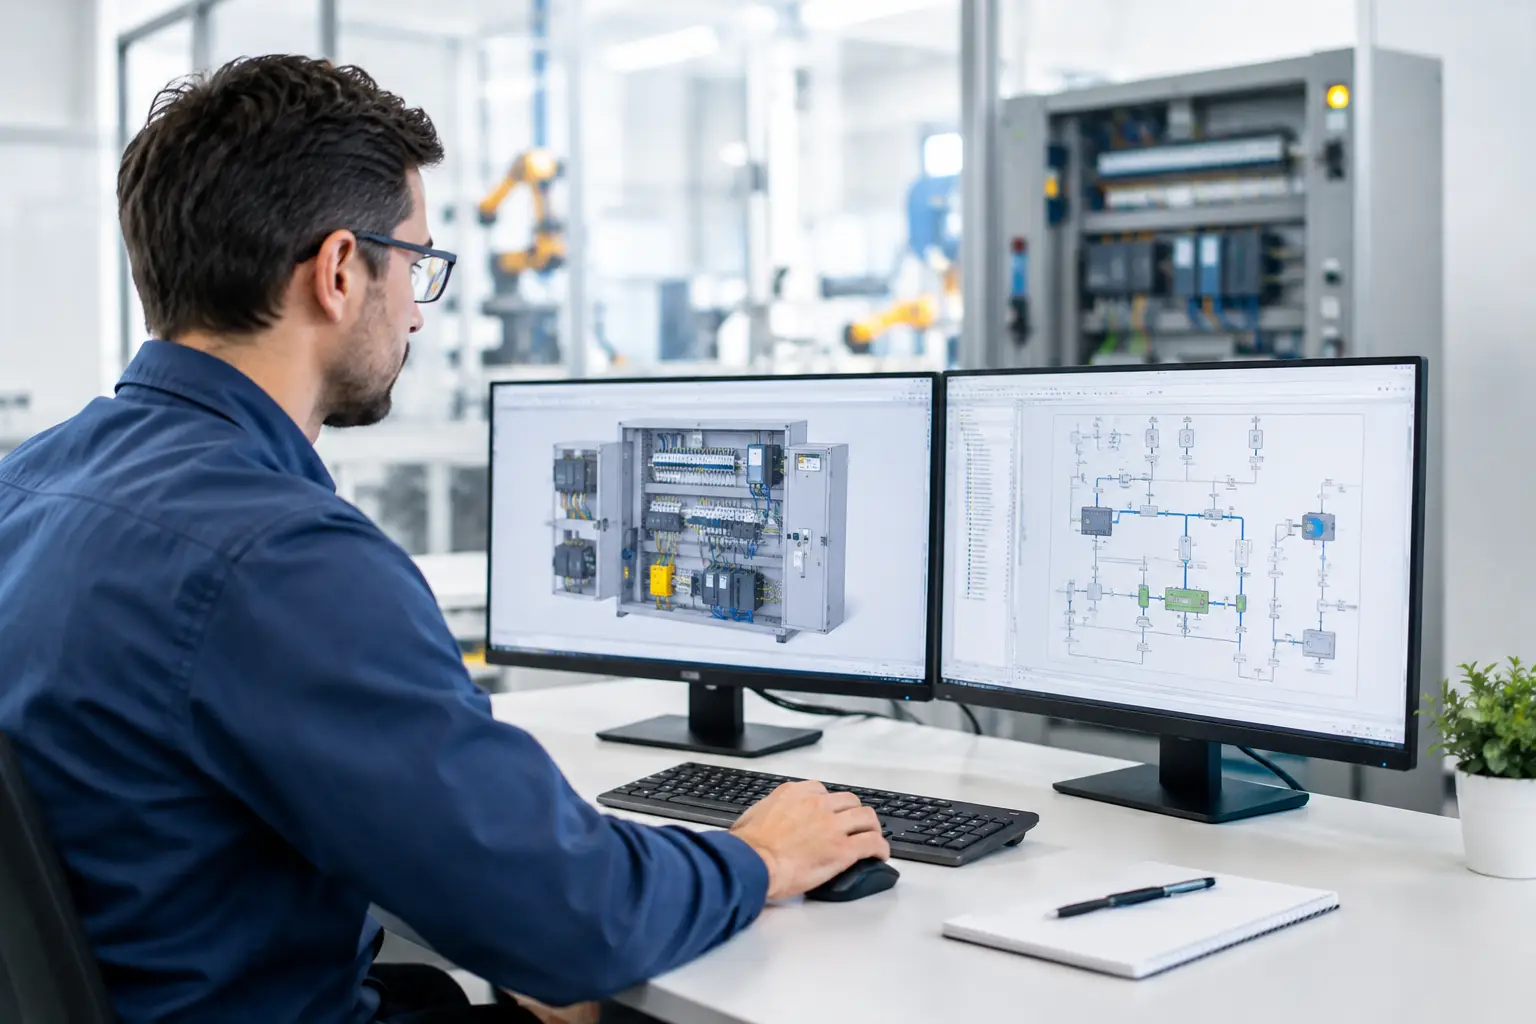
En muchos casos, el mayor potencial de mejora está en reducir el tiempo medio de reparación. Un tablero correctamente identificado, un respaldo validado de PLC y HMI, diagramas eléctricos actualizados y una lista de señales I/O reducen incertidumbre durante una contingencia.
El mantenimiento debe incluir automatización e instrumentación
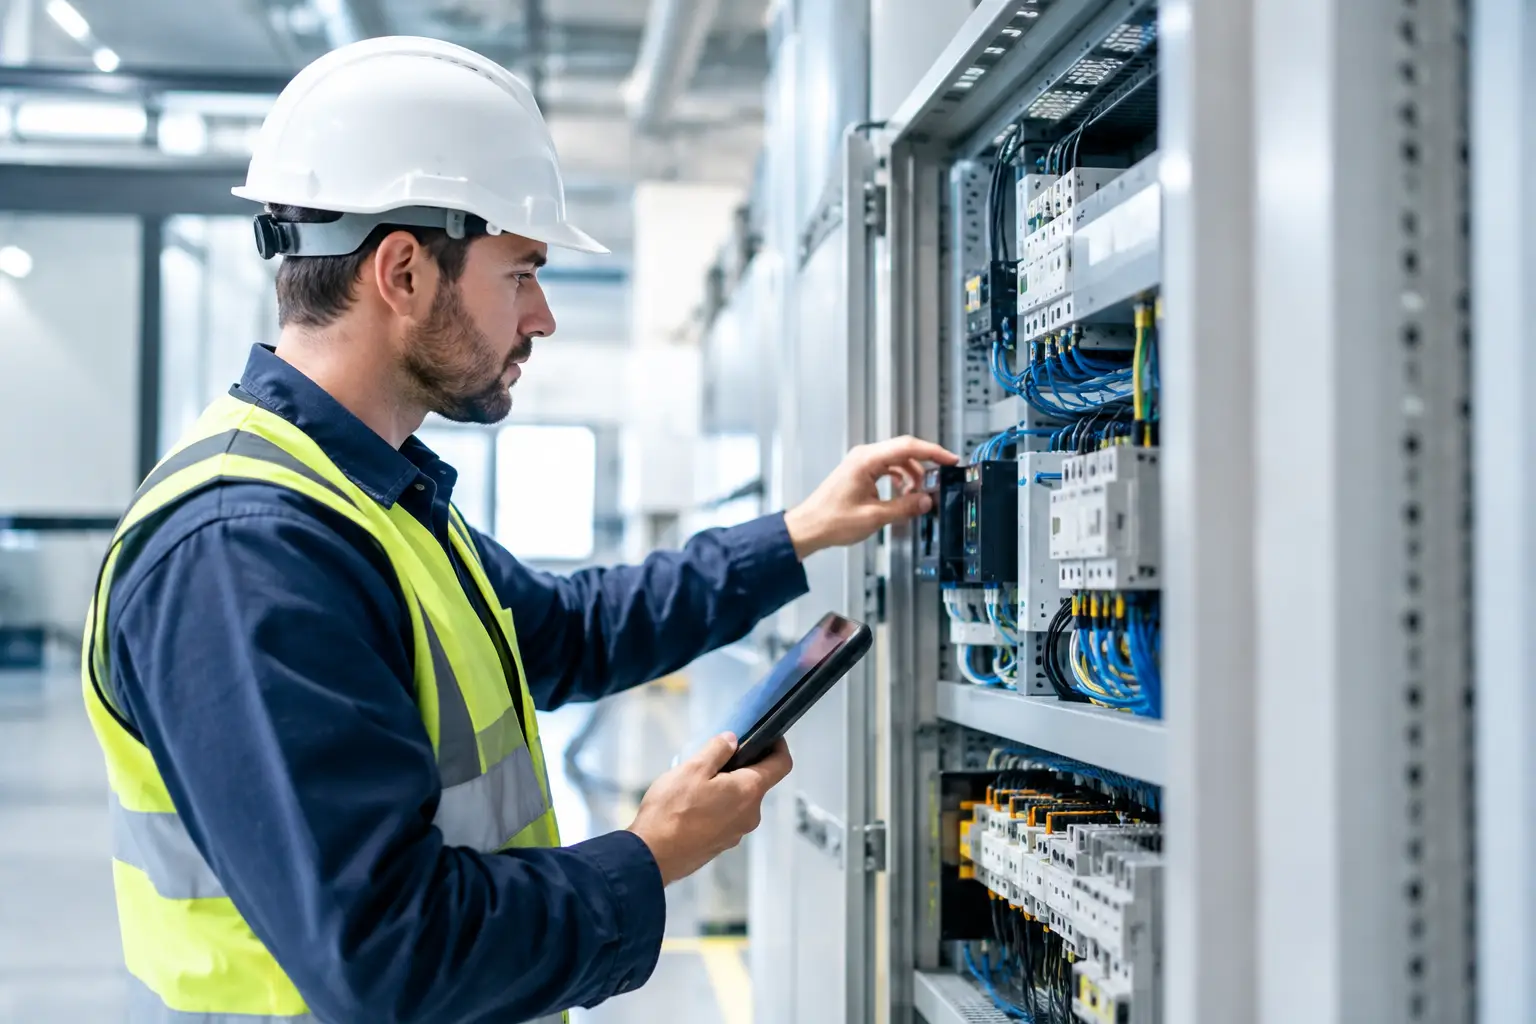
El mantenimiento preventivo suele concentrarse en componentes mecánicos y eléctricos visibles. Sin embargo, la automatización también envejece. Fuentes de alimentación, módulos de entradas y salidas, tarjetas de comunicación, ventilación de gabinetes, bornes, UPS, switches industriales, conectores y cableado de señal requieren inspección y criterios de reemplazo.
En instrumentación, una medición incorrecta puede provocar paros aparentemente inexplicables. Un transmisor de presión con deriva, una celda de carga mal calibrada, un interruptor de nivel con acumulación de producto o un cable de señal expuesto a interferencia puede activar interlocks legítimos desde la lógica de control. Sustituir el PLC no corrige una variable de proceso mal medida.
La rutina debe incluir verificación de calibración cuando aplique, revisión de instalación, inspección de tierras y blindajes, validación de escalamiento en PLC y HMI, así como pruebas funcionales de alarmas e interlocks. En procesos con control PID, también conviene revisar sintonía, límites de salida, modos manual y automático, y comportamiento ante pérdida de señal. Un lazo inestable puede forzar paros de protección o deteriorar el desempeño de equipos aguas abajo.
Proteja los respaldos y controle los cambios
Una planta puede contar con hardware disponible y aun así prolongar un paro si nadie puede cargar el programa correcto. Los respaldos deben corresponder a la versión instalada, estar identificados, resguardados y verificados mediante procedimientos definidos. Esto incluye software de PLC, HMI, SCADA, variadores, servodrives, parámetros de instrumentación inteligente y configuraciones de red.
El control de cambios es igualmente crítico. Cada modificación en lógica, pantallas, setpoints, recetas, comunicaciones o protecciones debe documentar motivo, responsable, fecha, pruebas ejecutadas y condición de reversión. En sectores regulados, esta trazabilidad puede relacionarse además con requerimientos de GAMP 5 o 21 CFR Part 11, según el alcance del sistema.
Antes de intervenir un proceso crítico, es recomendable revisar la especificación funcional, la arquitectura de control y los P&ID aplicables. Cuando se modifica una secuencia de operación sin revisar sus interdependencias, puede aparecer una condición de carrera, una alarma mal enclavada o una secuencia de arranque insegura que solo se evidencia en producción.
Modernice antes de que la obsolescencia detenga la planta
La obsolescencia no se limita a equipos descontinuados. También incluye plataformas sin soporte técnico, módulos sin disponibilidad confiable, software incompatible con sistemas actuales, redes con baja capacidad de diagnóstico y arquitecturas que dependen de una sola persona. Esperar a que falle un PLC antiguo para iniciar una migración casi siempre incrementa el riesgo, el costo y la duración del paro.
Una modernización bien ejecutada comienza con levantamiento en sitio e inventario de activos. Debe revisar tarjetas instaladas, señales I/O, redes como PROFINET o PROFIBUS, protocolos de terceros, tableros existentes, cargas eléctricas, interlocks, filosofía de alarmas y restricciones de producción. Con esta información se puede definir una migración por etapas, con ventanas de paro controladas y puntos claros de reversión.
En plataformas Siemens, por ejemplo, la migración hacia SIMATIC S7 con TIA Portal puede incluir actualización de PLC, HMI, redes, variadores SINAMICS y documentación. Pero la plataforma por sí sola no garantiza disponibilidad. El valor está en especificar la arquitectura adecuada, programar con estándares consistentes, probar la integración y validar en campo el comportamiento de cada señal y secuencia.
Pruebe fuera de producción y comisione con método
Las pruebas FAT reducen el riesgo antes de instalar tableros, software y dispositivos en planta. Permiten revisar listas I/O, comunicaciones, alarmas, pantallas HMI, secuencias automáticas, permisos de operación y condiciones de falla en un entorno controlado. No reemplazan las pruebas de sitio, pero evitan que defectos básicos consuman una ventana de producción.
Durante SAT, I/O Check y puesta en marcha, el enfoque debe ser funcional y documentado. Cada señal debe verificarse desde campo hasta la visualización y la acción de control; cada interlock debe probarse contra su causa real o una simulación segura; y cada motor debe confirmar sentido de giro, protecciones, modos de operación y respuesta ante fallas. En sistemas eléctricos, la coordinación entre protecciones, control de motores y secuencias PLC es determinante.
Las pruebas también deben contemplar escenarios de recuperación. No basta con demostrar que el equipo arranca correctamente. Es necesario verificar qué ocurre después de una pérdida de energía, falla de comunicación, paro de emergencia, cambio de modo, desconexión de un instrumento o reinicio del controlador. Estos escenarios definen cuánto tarda la planta en volver a una condición segura y productiva.
Integre la información para diagnosticar más rápido
Un SCADA o HMI bien configurado no debe limitarse a mostrar estados. Debe ayudar a diagnosticar. Alarmas con prioridad coherente, descripciones claras, registro histórico, tendencias de variables críticas y visualización de estados permisivos reducen el tiempo que el personal dedica a buscar el origen de una detención.
La prioridad es evitar inundación de alarmas. Cuando un evento genera decenas de mensajes sin jerarquía, el operador pierde contexto. La filosofía de alarmas debe separar causa y consecuencia, definir prioridades y asegurar que cada alarma requiera una acción identificable. ISA ofrece criterios útiles para estructurar esta práctica según las necesidades del proyecto.
ProAIC Automatización puede participar desde el diagnóstico de fallas recurrentes y la ingeniería de modernización hasta la fabricación de tableros, programación, FAT, SAT y puesta en marcha. Este alcance integral ayuda a evitar vacíos entre disciplinas, especialmente cuando una causa combina control, instrumentación, comunicaciones y sistemas eléctricos.
La continuidad operativa se construye con decisiones verificables: conocer qué activos son críticos, mantener documentación útil, probar cambios antes de producción y modernizar con una secuencia controlada. Cada paro analizado con rigor puede convertirse en una mejora permanente del proceso, no solo en una reparación de emergencia.